ChatGPT salió el 30 de noviembre de 2022 y en pocos días todo el mundo estaba hablando de lo mismo. En aquel momento parecía una locura, pero visto desde hoy fue solo el inicio. Desde entonces las compañías de AI están en una carrera por ver qué modelo es mejor que otro, y a la vez por llevar al mercado las aplicaciones más competitivas para esos modelos.
Yo trabajo con estas herramientas todos los días y quiero compartir algo que vengo pensando hace un tiempo.
Los modelos que ya teníamos eran buenos
Cuando salió Sonnet 4.6 en febrero de 2026 ya podíamos resolver muchísimos problemas. En programación podías hacer software listo para producción. Anthropic reportó cerca de 79.6% en SWE-bench Verified, muy cerca de Opus 4.6 (80.8%), y en sus pruebas los desarrolladores preferían Sonnet 4.6 sobre Opus 4.5 un 59% de las veces. Las herramientas también mejoraron mucho, Claude Code, OpenCode, Codex, y los desarrolladores las usábamos y obteníamos muy buenos resultados.
Pero la industria es muy ambiciosa y muy comercial. Cada vez que sale un modelo más grande, las tareas que hacías sin problema con el modelo anterior de repente "ya no son eficientes" con ese modelo. La tarea es la misma, el modelo que la resolvía sigue ahí, pero el mensaje cambia. Yo me pregunto si eso no es también una estrategia comercial.
Opus para todo
Durante un tiempo la sensación era que Opus era el modelo que tenías que usar para todo. Es cierto que es más potente, pero y las tareas que no lo necesitan? Leer diez archivos, generar un test, escribir un archivo de configuración o renombrar variables no necesita el mejor razonamiento del mercado.
Lo curioso es que la propia guía de Claude Code hoy dice que Sonnet es el modelo por defecto y el correcto para la gran mayoría del trabajo de código, y que Opus "usa bastante más de tu cuota", así que conviene activarlo cuando lo necesitas y no dejarlo siempre encendido. O sea, hasta el proveedor reconoce que elegir el modelo es la palanca principal para controlar el consumo.
Y el consumo no es poca cosa. Los modelos más grandes cuestan más por token, y además según la documentación de Anthropic los modelos desde la versión 4.7 usan un tokenizador que genera alrededor de 30% más tokens para el mismo texto. Los planes fueron creciendo, se crearon otros nuevos, pero nunca te llega a alcanzar. Así funciona la sociedad de consumo.
Lo que hizo Spotify
A principios de septiembre Spotify publicó en su blog de ingeniería un artículo de Dimitri Mazmanov que se llama "Portal by Spotify cut my Claude Code token usage by 90%". Lo que hicieron no fue usar herramientas para comprimir prompts ni trucos de contexto. Simplemente enrutaron las tareas correctamente.
Usaron Claude Code con hooks que interceptan las llamadas a herramientas antes de ejecutarlas. Si Claude intenta leer un archivo de más de 350 líneas, el hook lo bloquea y esa lectura se delega a un modelo más barato, en su caso Gemini 2.5 Flash, que lee el archivo y le devuelve a Claude solo un resumen con lo que necesita. Tienen un modo para lectura masiva de archivos y otro para escribir código repetitivo, tests y configuración directamente a disco, sin que Claude tenga que cargar todo eso en su contexto. Como dicen en el artículo, ese agente no necesita pensar, funciona como entrada y salida.
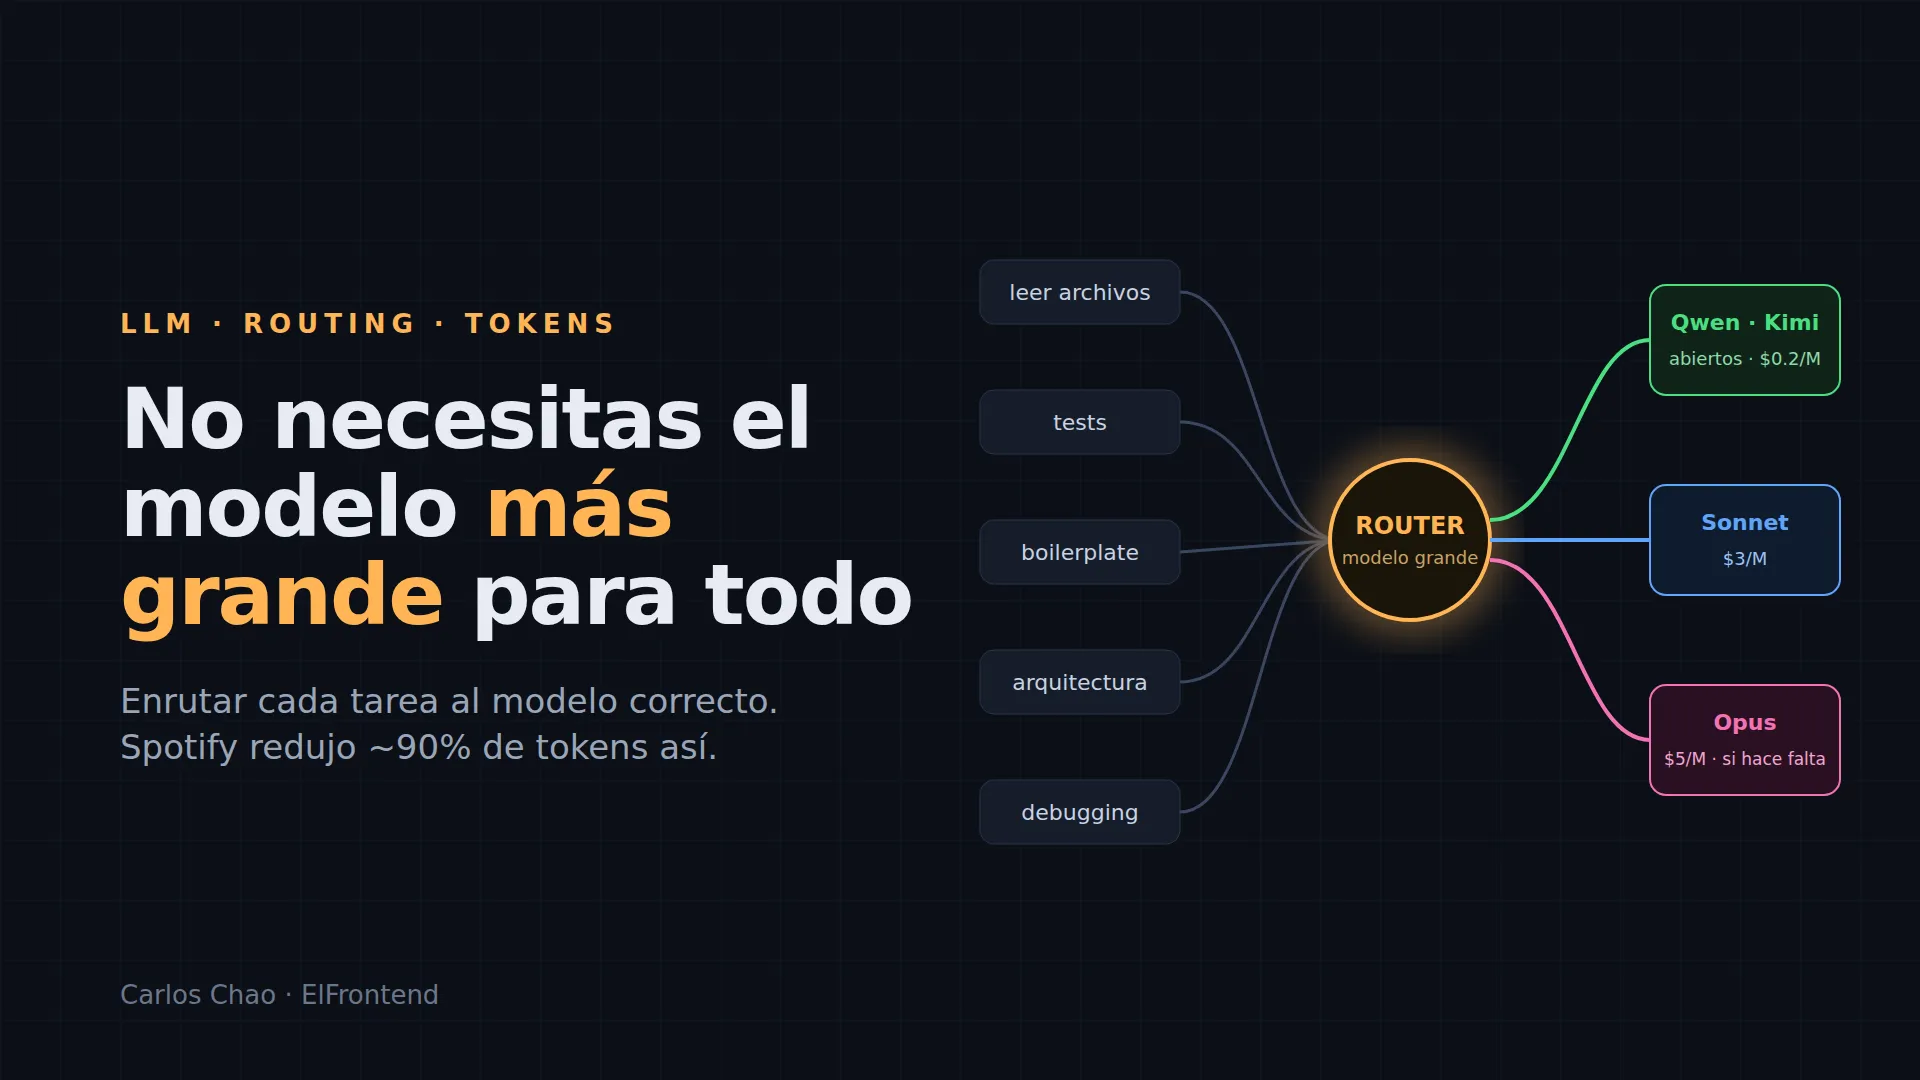
El resultado fue un ahorro promedio de alrededor de 90% de tokens en lecturas masivas, medido en cuatro escenarios sobre un monorepo de Java. Ellos mismos dejan claro los límites: no delegan edición, ni razonamiento, ni depuración, cada delegación agrega entre 10 y 30 segundos de latencia, y para archivos pequeños no vale la pena. Me parece importante decirlo porque lo que hicieron fue poner cada tarea en el modelo que le corresponde.
Los modelos abiertos ya están ahí
Hay muchísimos modelos abiertos con muy buena calidad. Qwen, Kimi, MiniMax, GLM, DeepSeek. Muchos cuestan una fracción de lo que cuesta un modelo frontier y en benchmarks de código están bastante cerca.
| Modelo | Tipo | Precio por millón de tokens (entrada / salida) | SWE-bench Verified |
|---|---|---|---|
| Claude Opus 4.6 / 4.8 / 5 | Cerrado | $5 / $25 | 80.8% (Opus 4.6) |
| Claude Sonnet 4.6 | Cerrado | $3 / $15 | ~79.6% |
| Claude Haiku 4.5 | Cerrado | $1 / $5 | |
| MiniMax M2.5 | Abierto | $0.30 / $1.20 | 80.2% |
| Kimi K2.5 | Abierto | ~$0.40 / ~$1.50 | 76.8% |
| Qwen3-Coder-Next | Abierto | $0.22 / $1.00 | 70.6% |
| Kimi K3 | Abierto | desde $2.10 / $10.95 (OpenRouter) |
Los números de benchmark de los modelos abiertos son en su mayoría reportados por los propios laboratorios, así que hay que tomarlos con cuidado. Pero aunque les quites unos puntos, para leer archivos, generar boilerplate o escribir tests sobran.
Para verlo más claro hice una cuenta sencilla. Imagina una sesión de trabajo que consume 2 millones de tokens de entrada y 200 mil de salida.
| Todo con | Costo aproximado |
|---|---|
| Opus | $15.00 |
| Sonnet 4.6 | $9.00 |
| Haiku 4.5 | $3.00 |
| MiniMax M2.5 | $0.84 |
| Qwen3-Coder-Next | $0.64 |
Ahora imagina que un enrutador manda el 70% de esa sesión (lecturas, boilerplate, tests) a Qwen, el 20% a Sonnet y solo el 10% que de verdad necesita razonamiento pesado a Opus. El costo baja a unos $3.75, cerca de 75% menos que hacerlo todo con Opus. Es un ejemplo ilustrativo, pero va en la misma línea de lo que ya se ha medido. En 2024 el equipo de LMSYS publicó RouteLLM y mostró que un enrutador podía reducir costos hasta 85% manteniendo el 95% del rendimiento de GPT-4 en MT Bench.
Un modelo grande que decida, y los demás que trabajen
Entonces por qué no dejar esas tareas simples a estos modelos e ir enrutando por complejidad? La idea es tener un enrutador, que puede ser un modelo grande, que tome las decisiones. Él entiende el problema, planifica, decide qué parte necesita razonamiento de verdad y qué parte es trabajo mecánico, y reparte. El modelo caro se queda con lo que solo él puede hacer, y los modelos baratos o abiertos hacen el resto.
Esto también tiene otra ventaja. Si tu flujo depende de un solo proveedor, dependes de sus precios, de sus límites y de sus decisiones comerciales. Si tu flujo sabe enrutar, puedes cambiar un modelo por otro cuando salga uno mejor o más barato, sin reescribir todo.
Yo creo que el futuro del uso de la AI va a pasar por herramientas así, que sepan aprovechar bien las capacidades de cada modelo y no de un proveedor en específico.
Fuentes
- Spotify Engineering, "Portal by Spotify cut my Claude Code token usage by 90%": https://engineering.atspotify.com/2026/9/portal-by-spotify-cut-my-claude-code-token-usage-by-90
- Tednología, "Ahorra 90% en tokens de Claude con Portal de Spotify": https://blog.tednologia.com/ahorra-90-en-tokens-de-claude-con-portal-de-spotify/
- Techzine, "Spotify reduces Claude Code token usage by 90 percent": https://www.techzine.eu/news/devops/144093/spotify-reduces-claude-code-token-usage-by-90-percent/
- Anthropic, "Introducing Claude Sonnet 4.6": https://www.anthropic.com/news/claude-sonnet-4-6
- Anthropic, precios de la API: https://platform.claude.com/docs/en/about-claude/pricing
- Claude Help Center, "Models, usage, and limits in Claude Code": https://support.claude.com/en/articles/14552983-models-usage-and-limits-in-claude-code
- Morph, "Best Open-Source Coding Model 2026": https://www.morphllm.com/best-open-source-coding-model-2026
- OpenRouter, Kimi K3: https://openrouter.ai/moonshotai/kimi-k3
- LMSYS, RouteLLM: https://github.com/lm-sys/routellm